De la question en langage courant à l’insight : comment l’IA transforme la visualisation de données
La plupart des données d’entreprise ne sont jamais consultées. Elles dorment dans des bases de données, des entrepôts et des tableurs, en attendant quelqu’un qui maîtrise les requêtes et dispose du bon tableau de bord pour les faire parler.
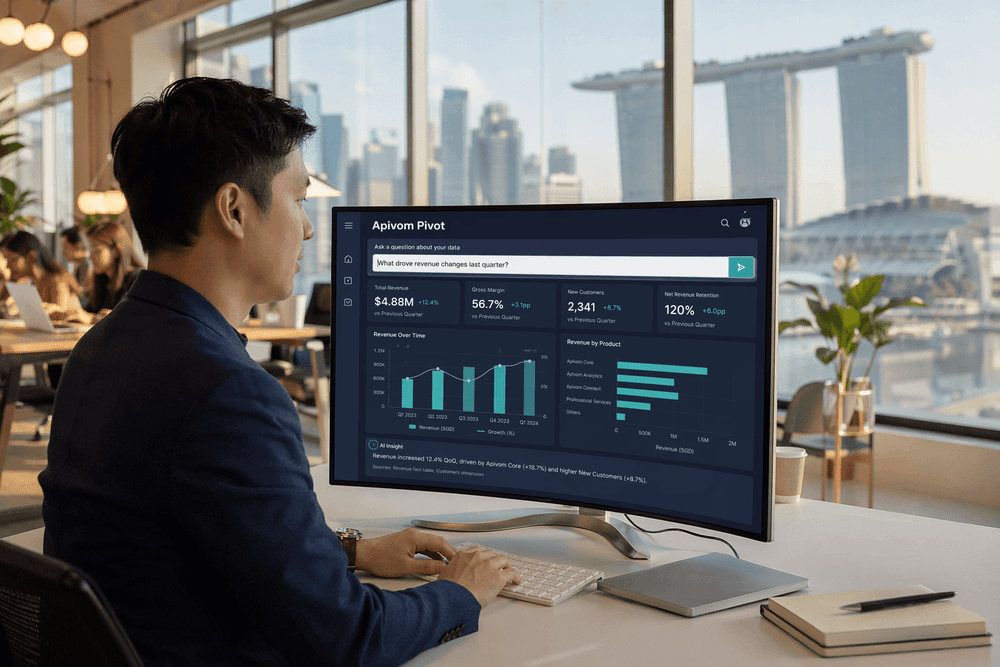
La plupart des données d’entreprise ne sont jamais consultées. Elles dorment dans des bases de données, des entrepôts et des tableurs, en attendant quelqu’un qui maîtrise les requêtes et dispose du bon tableau de bord pour les faire parler. Pendant des années, l’écart entre posséder des données et les comprendre a été l’un des problèmes les plus discrets, mais aussi les plus coûteux, des entreprises. La visualisation de données pilotée par l’IA comble cet écart : elle transforme une question saisie en graphique en quelques secondes.
Cet article explique comment fonctionne réellement l’intelligence des données en langage naturel, où elle apporte de la valeur et ce qu’il faut surveiller avant de lui confier des décisions. Nous commencerons par poser les bases de la technologie, puis nous montrerons comment l’approche d’Apivom Pivot s’y inscrit.
Le vrai goulot d’étranglement n’a jamais été la donnée
Les organisations ne manquent pas de données. D’après des enquêtes sectorielles, le volume des données d’entreprise double à peu près tous les deux ans, et pourtant la plupart des équipes déclarent n’en utiliser qu’une fraction pour décider. La contrainte n’est que rarement le stockage ou la collecte : c’est la traduction.
Pour répondre à une question simple comme « Quelles régions ont décroché sur les renouvellements le trimestre dernier ? », un responsable non technique a traditionnellement besoin de trois choses :
- Quelqu’un qui connaît le modèle de données et sait écrire du SQL ou une requête de BI.
- Un tableau de bord qui contient déjà, par hasard, exactement cette découpe des données.
- Du temps, généralement une journée ou plus dans une file de demandes.
Quand l’un de ces éléments manque, la question reste sans réponse ou est remplacée par une intuition. Multipliez cela par des centaines de petites décisions chaque semaine, et le coût de cet écart de traduction devient énorme. C’est précisément l’écart que cible l’analyse en langage naturel.
Comment fonctionne l’intelligence des données en langage naturel
L’expression « posez une question à vos données » ressemble à du marketing, mais derrière elle se cache un pipeline concret en plusieurs étapes. Comprendre ces étapes aide à juger où ces systèmes sont fiables et où ils ne le sont pas.
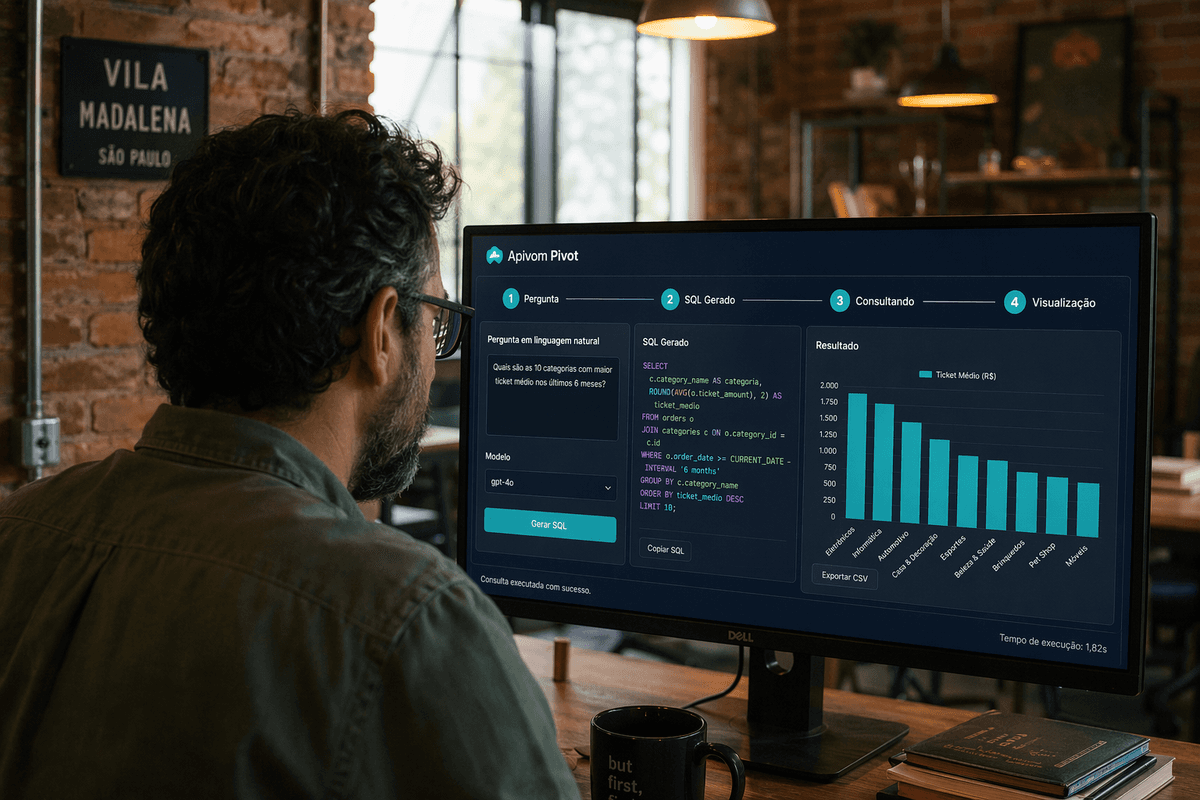
Étape 1 : comprendre l’intention
Le système analyse d’abord la question pour déterminer ce qui est demandé : la métrique (renouvellements), la dimension (région), le filtre (le trimestre dernier) et la comparaison souhaitée. Les systèmes modernes utilisent ici un grand modèle de langage, mais les bons le contraignent fortement avec le contexte du schéma afin qu’il n’invente pas de colonnes inexistantes.
Étape 2 : générer la requête
Ensuite, l’intention est traduite en une véritable requête de base de données, généralement en SQL. C’est l’étape qui exigeait historiquement un analyste humain. Un système bien conçu ancre le modèle dans les noms réels des tables et des colonnes, leurs relations et leurs types de données, de sorte que la requête générée soit à la fois valide et sûre à exécuter.
Étape 3 : choisir la visualisation
Les résultats bruts d’une requête ne sont que des lignes. Une tendance dans le temps appelle un graphique en courbes ; une répartition parties-tout appelle un histogramme ou un graphique en anneau ; une découpe géographique appelle une carte. Les systèmes matures choisissent le type de graphique d’après la forme du résultat, et non au hasard, ce qui rend le résultat lisible sans mise en forme manuelle.
Étape 4 : expliquer le résultat
La dernière étape, souvent négligée, est la narration : un court résumé en langage clair de ce que montre le graphique, qu’il s’agisse de la valeur aberrante, de la tendance ou de la répartition 80/20. C’est ce qui transforme une visualisation en véritable insight qu’un dirigeant pressé peut exploiter.
Où elle apporte de la valeur, et où elle n’en apporte pas
L’analyse en langage naturel n’a rien de magique, et la traiter comme telle est le moyen le plus rapide de perdre la confiance qu’on lui porte. Elle excelle dans certaines situations et peine dans d’autres.
Elle fonctionne bien pour :
- Les questions exploratoires (« Montre-moi le risque d’attrition par gamme de produits »), où la rapidité compte plus que la précision parfaite.
- Le libre-service pour les non-analystes : permettre à un responsable commercial ou financier de répondre lui-même à ses questions sans ouvrir de ticket.
- La découverte de premier niveau : faire émerger des anomalies, des tendances et des segments qui méritent un examen plus approfondi.
Elle peine avec :
- Les termes métier ambigus : si « client actif » a trois significations différentes selon les services, le système a besoin d’une couche de métriques définie, pas d’une supposition.
- Le reporting très encadré : les chiffres réglementaires ou financiers exigent toujours des requêtes auditées et versionnées.
- La logique profondément imbriquée : les calculs en plusieurs étapes avec des cas limites gagnent toujours à être relus par un analyste humain.
Ce qu’il faut en retenir en pratique : utilisez la visualisation par IA pour accélérer le chemin vers la réponse à une question, et gardez un humain dans la boucle partout où la réponse conditionne une décision réglementée ou à fort enjeu.
Les garde-fous comptent plus que les modèles
La plus grande différence entre une démonstration jouet et un système de niveau production tient aux garde-fous. Un modèle capable d’écrire n’importe quel SQL peut aussi écrire une requête lente, coûteuse ou dangereuse. Les systèmes de production entourent l’étape de génération de protections :
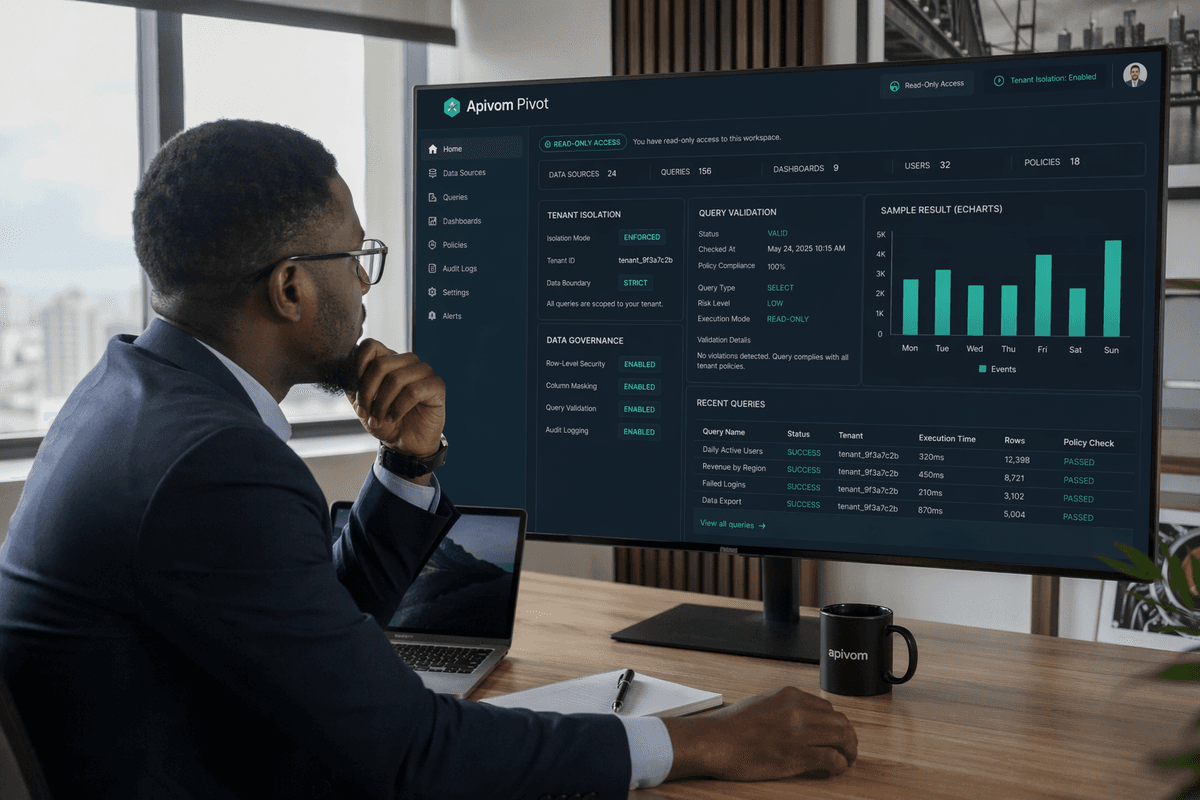
- Un accès en lecture seule, pour qu’une question ne puisse jamais modifier les données.
- Un ancrage dans le schéma, pour que le modèle ne référence que des tables réelles et autorisées.
- Une isolation des locataires, pour que la question d’un client ne touche jamais les données d’un autre.
- Une validation et des limites sur les requêtes, pour qu’une requête incontrôlée ne puisse pas surcharger la base de données.
Si vous évaluez un outil d’analyse en langage naturel, ces garde-fous doivent être la première chose dont vous vous enquérez, bien avant l’esthétique des graphiques. Une passerelle d’API solide est souvent l’endroit où ces protections sont appliquées de manière cohérente à travers les services.
L’approche d’Apivom Pivot
C’est là qu’Apivom Pivot comble l’écart. Pivot est conçu comme une couche d’intelligence des données en langage naturel qui suit exactement le pipeline en quatre étapes décrit plus haut (intention, requête, visualisation, explication), mais qui entoure chaque étape de garde-fous de niveau production par défaut.
Une question saisie en langage courant est acheminée dans un pipeline multi-agents : une étape interprète l’intention, une autre ancre et génère le SQL sur le schéma réel, une troisième sélectionne la visualisation ECharts adaptée à partir de la forme du résultat, et une dernière rédige un court résumé narratif. Chaque requête s’exécute en lecture seule et isolée par locataire, de sorte que la même question est sans risque qu’elle vienne d’un responsable commercial ou d’un responsable financier.
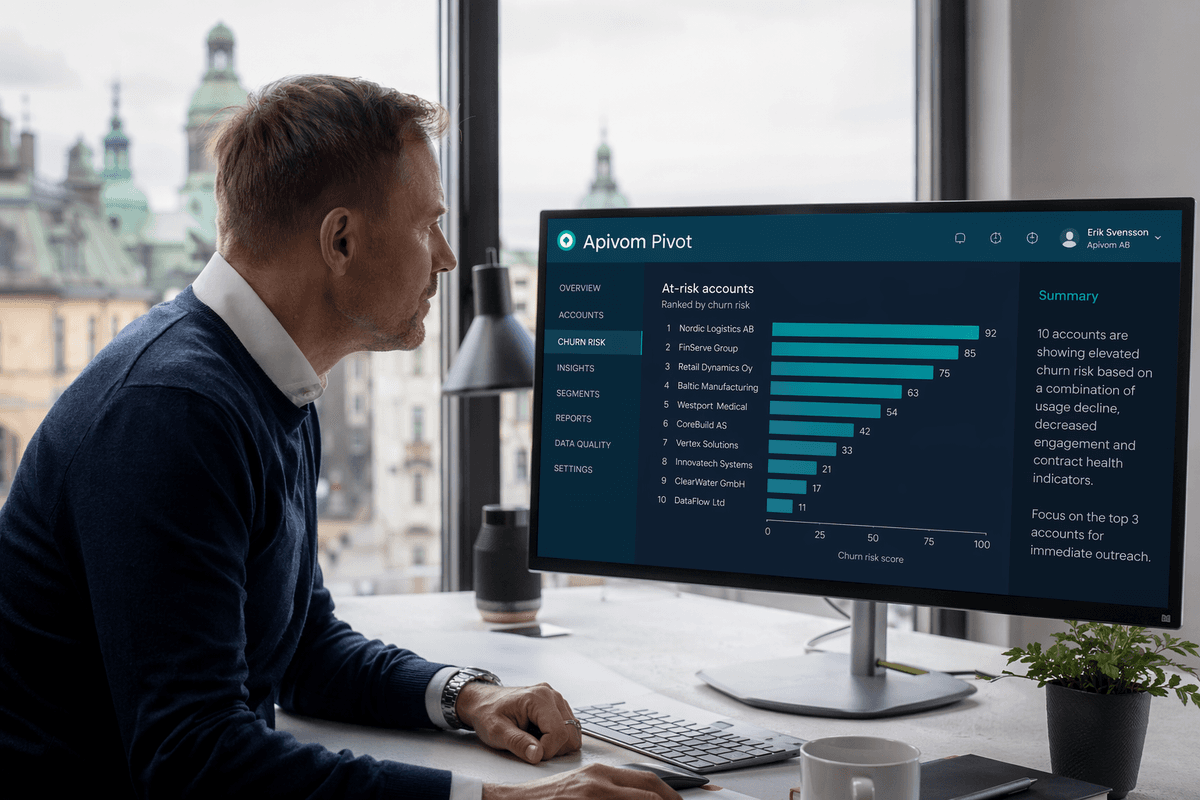
Comme Pivot se connecte aux données opérationnelles en direct via la même passerelle que celle qui alimente le reste de la plateforme, y compris Apivom Iris pour les données clients et de revenus, les réponses reflètent l’état actuel de l’entreprise, et non un export nocturne périmé. Résultat : quelqu’un sans compétences SQL peut demander « Quels comptes présentent le plus fort risque d’attrition ce trimestre ? » et obtenir en quelques secondes un graphique classé accompagné d’une explication d’un paragraphe.
Ce que cela change en pratique
Le passage de la construction de tableaux de bord à la formulation de questions change qui peut utiliser les données. Lorsqu’un responsable peut répondre à une question de suivi en dix secondes au lieu de déposer une demande et d’attendre une journée, c’est tout le rythme de la prise de décision qui s’accélère.
Les résultats mesurables sont concrets : le temps des analystes, libéré des demandes de requêtes ponctuelles, est redirigé vers des travaux plus approfondis ; le délai entre la question et la réponse passe de plusieurs jours à quelques secondes ; et les décisions qui reposaient auparavant sur l’intuition commencent à s’appuyer sur les chiffres réels. La visualisation pilotée par l’IA ne remplace pas les analystes : elle supprime la file d’attente devant eux et offre à tous les autres un chemin plus rapide vers des données qui leur appartiennent déjà.